<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://billhan01.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://billhan01.github.io/" rel="alternate" type="text/html" /><updated>2026-08-13T22:25:48+08:00</updated><id>https://billhan01.github.io/feed.xml</id><title type="html">Jiarui Han’s Personal Page</title><subtitle>Personal website of Jiarui Han</subtitle><author><name>Jiarui Han</name><email>tjbillhan@gmail.com</email></author><entry><title type="html">一点关于正则化的笔记</title><link href="https://billhan01.github.io/posts/2025/07/%E4%B8%80%E7%82%B9%E5%85%B3%E4%BA%8E%E6%AD%A3%E5%88%99%E5%8C%96%E7%9A%84%E7%AC%94%E8%AE%B0/" rel="alternate" type="text/html" title="一点关于正则化的笔记" /><published>2025-07-19T00:00:00+08:00</published><updated>2025-07-19T00:00:00+08:00</updated><id>https://billhan01.github.io/posts/2025/07/%E4%B8%80%E7%82%B9%E5%85%B3%E4%BA%8E%E6%AD%A3%E5%88%99%E5%8C%96%E7%9A%84%E7%AC%94%E8%AE%B0</id><content type="html" xml:base="https://billhan01.github.io/posts/2025/07/%E4%B8%80%E7%82%B9%E5%85%B3%E4%BA%8E%E6%AD%A3%E5%88%99%E5%8C%96%E7%9A%84%E7%AC%94%E8%AE%B0/"><![CDATA[<p>最近被同学问到了机器学习里正则化这一概念的一些问题，包括如何理解 L1 和 L2 正则化起到的效果。在讨论的过程中，我们从约束的角度尝试理解了为什么 L1 正则化可能使参数为 0，而 L2 正则化更倾向于缩小参数。</p>

<hr />
<h2 id="正则化的概念">正则化的概念</h2>

<p>首先回顾一下正则化的相关概念：</p>

<blockquote>
  <p>为了防止模型过拟合，机器学习中经常会在损失函数中加入正则项，称之为<strong>正则化（Regularization）</strong>。通过在损失函数上加上某些规则（限制），缩小解空间，从而减少求出过拟合解的可能性。</p>
</blockquote>

<p>设目标函数为 $f(w)$，正则项为 $R(w)$，则带正则项的优化问题表示为：
\(\min_{w \in \mathbb{R}^n} \; f(w) + \lambda R(w)\)
其中：</p>
<ul>
  <li>$w \in \mathbb{R}^n$ ：模型参数；</li>
  <li>$f(w)$：经验损失函数（如平方误差、交叉熵等）；</li>
  <li>$R(w)$：正则项（regularizer）；</li>
  <li>$\lambda &gt; 0$：正则化系数，调控正则项与损失项之间的权衡。</li>
</ul>

<blockquote>
  <p><strong>L2 正则化</strong>，又称为 <strong>Ridge 正则化</strong>，通过惩罚参数向量的 L2 范数平方，鼓励权重向量整体收缩（shrinkage），从而提升模型的稳定性与泛化能力。</p>
</blockquote>

<p>L2 正则项定义为参数平方和：</p>

\[R_{L2}(w) = \|w\|_2^2 = \sum_{i=1}^{n} w_i^2\]

<p>对应的正则化优化问题为：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) + \lambda \|w\|_2^2\]

<p>L2 正则化具有一些基本特性：</p>

<ul>
  <li>
    <p><strong>可导性强</strong>：L2 正则项为光滑函数（smooth function），一阶导数连续，因此适用于梯度下降类优化方法。</p>
  </li>
  <li>
    <p><strong>整体收缩效应（Weight Shrinkage）</strong>：L2 正则化会对每个参数 $w_i$ 施加与其平方成正比的惩罚项。对于绝对值较大的权重，其平方更大，惩罚显著；而对于接近零的权重，其平方趋近于零，几乎不受到惩罚。具体而言：</p>

\[\text{若} \ |w_i| \gg 1 \Rightarrow w_i^2 \gg 1 \Rightarrow \text{惩罚项大} \\
\text{若} \ |w_i| \ll 1 \Rightarrow w_i^2 \ll 1 \Rightarrow \text{惩罚项小}\]

    <p>因此，L2 正则化不会诱导稀疏性（不会使 $w_i$ 精确为 0），但能有效抑制过大的权重。</p>
  </li>
  <li>
    <p><strong>数值稳定性与解的存在性（闭式解）</strong>：在使用正规方程（Normal Equation）求解线性回归参数时，L2 正则化能确保矩阵求逆时始终存在逆，即使特征矩阵 $X$ 存在共线性问题。令目标函数为最小二乘损失：</p>

\[\min_{w} \; \|Xw - y\|_2^2 + \lambda \|w\|_2^2\]

    <p>对应的解析解为：</p>

\[w^* = (X^\top X + \lambda I)^{-1} X^\top y\]

    <p>由于 $\lambda &gt; 0$，矩阵 $X^\top X + \lambda I$ 始终是正定的，从而保证其可逆性，即逆 $(X^\top X + \lambda I)^{-1}$ 一定存在。这一性质提升了数值计算的稳定性。</p>
  </li>
</ul>

<blockquote>
  <p><strong>L1 正则化</strong>，又称为 <strong>Lasso 正则化</strong>，通过最小化参数向量的 L1 范数（即绝对值之和）来鼓励稀疏性。</p>
</blockquote>

<p>具体而言，L1 正则项定义为：
\(R_{L1}(w) = \|w\|_1 = \sum_{i=1}^{n} |w_i|\)</p>

<p>优化问题为：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) + \lambda \|w\|_1\]

<p>随着大规模特征数据的广泛应用，工业场景对模型的稀疏性和可解释性提出了更高要求。此时，L2 正则化已无法满足实际需求：虽然它可压缩参数幅度，使其趋近于零，但不会使权重真正等于零，因此无法直接“舍弃”冗余特征。</p>

<p>相比之下，L1 正则化具有明确的 <strong>稀疏性诱导能力</strong>。它在优化过程中倾向于使大量参数权重精确地收缩为零，进而实现显式的特征选择。优化完成后，所有满足 $w_i = 0$ 的特征可被忽略，从而减少模型存储与计算负担。</p>

<blockquote>
  <p><strong>L0 正则化</strong> 直接对参数向量中非零元素的个数进行惩罚，鼓励模型尽可能地使用更少的参数，从而达到稀疏性目的。</p>
</blockquote>

<p>令 $w = (w_1, w_2, \dots, w_n)^\top \in \mathbb{R}^n$，L0 正则项定义为：</p>

\[R_{L0}(w) = \|w\|_0 = \sum_{i=1}^{n} \mathbf{1}_{w_i \ne 0}\]

<p>对应的优化问题为：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) + \lambda \|w\|_0\]

<p>从直观上看，利用非零参数的个数，可以很好的来选择特征，实现特征稀疏的效果，具体操作时选择参数非零的特征即可。但因 L0 正则化很难求解，是个 NP-hard 问题，因此一般采用 L1 正则化。L1 正则化是 L0 正则化的最优凸近似，比 L0 容易求解，并且也可以实现稀疏的效果。</p>

<hr />

<h2 id="正则化问题与约束问题等价性的数学推导">正则化问题与约束问题等价性的数学推导</h2>

<h3 id="问题设定">问题设定</h3>
<p>设 $f: \mathbb{R}^n \to \mathbb{R}$ 为目标函数，$R: \mathbb{R}^n \to \mathbb{R}$ 为正则项或约束项。我们考虑以下两类优化问题：</p>

<p><strong>（1）正则化形式（惩罚形式）</strong>：</p>

\[(\mathbf{P1}) \quad \min_{w \in \mathbb{R}^n} \; f(w) + \lambda R(w), \quad \lambda &gt; 0\]

<p><strong>（2）约束形式</strong>：</p>

\[(\mathbf{P2}) \quad \min_{w \in \mathbb{R}^n} \; f(w) \quad \text{s.t.} \; R(w) \leq C, \quad C &gt; 0\]

<p>我们的目标是说明：在适当条件下，存在一一对应的参数 $\lambda \leftrightarrow C$，使得问题 $(\mathbf{P1})$ 与 $(\mathbf{P2})$ 在最优解上等价。</p>

<h3 id="拉格朗日对偶性构建">拉格朗日对偶性构建</h3>

<p>考虑约束问题 $(\mathbf{P2})$：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) \quad \text{s.t.} \; R(w) \leq C\]

<p>构造其 <strong>拉格朗日函数</strong>：</p>

\[L(w, \lambda) = f(w) + \lambda (R(w) - C), \quad \lambda \geq 0\]

<p>定义对应的 <strong>拉格朗日对偶函数</strong> $g(\lambda)$ 为：</p>

\[g(\lambda) = \inf_{w \in \mathbb{R}^n} L(w, \lambda) = \inf_{w} \left[ f(w) + \lambda (R(w) - C) \right]\]

<p>则对应的对偶问题为：</p>

\[(\mathbf{D}) \quad \max_{\lambda \geq 0} \; g(\lambda)\]

<h3 id="对偶函数提供原问题的下界">对偶函数提供原问题的下界</h3>

<p>对于任意 $\lambda \geq 0$，有：</p>

\[g(\lambda) \leq f(w), \quad \forall w \; \text{s.t.} \; R(w) \leq C\]

<p>因此，$g(\lambda)$ 是原问题 $(\mathbf{P2})$ 最优值的下界：</p>

\[g(\lambda) \leq f^*, \quad \forall \lambda \geq 0\]

<p>其中 $f^*$ 表示原问题的最优值。</p>

<h3 id="强对偶性与等价条件">强对偶性与等价条件</h3>

<p>若满足：</p>

<ul>
  <li>$f(w)$ 为凸函数；</li>
  <li>$R(w)$ 为凸函数；</li>
  <li>存在严格可行解 $\exists w_0, \; R(w_0) &lt; C$（满足 Slater 条件）；</li>
</ul>

<p>则根据凸优化中的 <strong>强对偶性定理</strong>，有：</p>

\[\max_{\lambda \geq 0} g(\lambda) = \min_{w, \; R(w) \leq C} f(w) = f^*\]

<p>并且，若 $w^<em>$ 为原问题最优解，$\lambda^</em>$ 为对偶问题最优解，则 $(w^<em>, \lambda^</em>)$ 满足 <strong>KKT 条件</strong>。</p>

<h3 id="kkt-最优性条件">KKT 最优性条件</h3>

<p>设约束函数 $g(w) := R(w) - C$，则 KKT 条件包括：</p>

<ul>
  <li>
    <p><strong>原始可行性（Primal feasibility）</strong>：</p>

\[R(w^*) \leq C\]
  </li>
  <li>
    <p><strong>对偶可行性（Dual feasibility）</strong>：</p>

\[\lambda^* \geq 0\]
  </li>
  <li>
    <p><strong>互补松弛性（Complementary slackness）</strong>：</p>

\[\lambda^* (R(w^*) - C) = 0\]
  </li>
  <li>
    <p><strong>最优性条件（Stationarity）</strong>：</p>

\[\nabla f(w^*) + \lambda^* \nabla R(w^*) = 0\]
  </li>
</ul>

<h3 id="与正则项问题的对应关系">与正则项问题的对应关系</h3>

<p>正则化问题 $(\mathbf{P1})$：</p>

\[\min_{w} \; f(w) + \lambda R(w)\]

<p>可以视为约束问题 $(\mathbf{P2})$ 的 <strong>拉格朗日松弛形式</strong>，其中 $\lambda$ 为拉格朗日乘子，$C$ 为约束上限。</p>

<p>若 $(w^<em>, \lambda^</em>)$ 满足 KKT 条件，则 $w^*$ 同时是 $(\mathbf{P1})$ 与 $(\mathbf{P2})$ 的最优解，且最优值相等。</p>

<p>因此，在满足强对偶条件的前提下，可建立如下参数映射关系：</p>

<ul>
  <li>对于每个 $\lambda &gt; 0$，存在唯一的 $C = R(w^*(\lambda))$ 使得 $(\mathbf{P1})$ 与 $(\mathbf{P2})$ 等价；</li>
  <li>反之，对于每个 $C &gt; 0$，存在对应的 $\lambda(C)$ 使等价成立。</li>
</ul>

<h3 id="结论">结论</h3>

<p><strong>定理（正则化-约束等价性）</strong>：</p>

<p>设 $f(w)$ 和 $R(w)$ 为凸函数，且存在 $w$ 满足 $R(w) &lt; C$。则以下两个优化问题：</p>

<ul>
  <li>
    <p>正则化形式：</p>

\[\min_{w} \; f(w) + \lambda R(w)\]
  </li>
  <li>
    <p>约束形式：</p>

\[\min_{w} \; f(w) \quad \text{s.t.} \; R(w) \leq C\]
  </li>
</ul>

<p>在某些参数对 $(\lambda, C)$ 下具有<strong>相同的最优解</strong>，并且满足强对偶性，最优值相等。</p>

<hr />

<h2 id="从约束优化角度理解-l1-与-l2-正则化的直观意义">从约束优化角度理解 L1 与 L2 正则化的直观意义</h2>

<p>根据前述推导，正则化问题：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) + \lambda R(w)\]

<p>在满足一定条件（如 $f(w)$ 与 $R(w)$ 为凸函数，且存在严格可行解）下，与约束问题：</p>

\[\min_{w \in \mathbb{R}^n} \; f(w) \quad \text{s.t.} \; R(w) \leq C\]

<p>是<strong>等价的</strong>，其中 $\lambda &gt; 0$ 是拉格朗日乘子，$C &gt; 0$ 为约束上限。这一结论为我们提供了对常用正则项的更直观几何解释：</p>

<h3 id="l2-正则化约束控制权重的欧氏长度">L2 正则化约束：控制权重的欧氏长度</h3>

<p>L2 正则化对应的正则项为：</p>

\[R_{L2}(w) = \|w\|_2^2 = \sum_{i=1}^{n} w_i^2\]

<p>其等价的约束形式为：</p>

\[\min_{w} \; f(w) \quad \text{s.t.} \; \|w\|_2^2 \leq C\]

<p>该约束表示所有参数向量 $w$ 必须落在一个以原点为中心的 L2 球（Euclidean ball）中，其几何形状是光滑的球面：</p>

<ul>
  <li>惩罚的是参数的整体<strong>能量大小（length squared）</strong>；</li>
  <li>没有偏向任何坐标轴方向；</li>
  <li>解通常为非稀疏的（所有参数趋于非零但较小）；</li>
  <li>具有良好的数值稳定性与解析可解性。</li>
</ul>

<h3 id="l1-正则化约束控制权重的绝对值和">L1 正则化约束：控制权重的绝对值和</h3>

<p>L1 正则化对应的正则项为：</p>

\[R_{L1}(w) = \|w\|_1 = \sum_{i=1}^{n} |w_i|\]

<p>其等价的约束形式为：</p>

\[\min_{w} \; f(w) \quad \text{s.t.} \; \|w\|_1 \leq C\]

<p>该约束限制参数向量必须位于一个以原点为中心的 L1 范数球（Manhattan ball）中。在二维情况下，该集合为菱形（diamond），在高维空间中呈现多面体状：</p>

<ul>
  <li>由于角点（vertices）落在坐标轴上，最优解倾向于出现在这些角点处；</li>
  <li>导致大量参数为 $0$，实现稀疏性诱导；</li>
  <li>适合特征选择与模型压缩等任务；</li>
  <li>优化问题为凸但不可微（在 $w_i = 0$ 处）。</li>
</ul>

<h3 id="几何直观等高线与约束边界的切点">几何直观：等高线与约束边界的切点</h3>

<p>考虑最小化损失函数 $f(w)$ 的等高线与正则项约束集合的几何交互：</p>

<ul>
  <li>在 L2 正则化下，等高线最早触碰到的是圆形边界的某点，通常落在内部平滑区域，导致参数非零但较小；</li>
  <li>在 L1 正则化下，等高线更易在边角点处达到最小值，从而使某些维度精确为零。</li>
</ul>

<h3 id="小结">小结</h3>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>L1 正则化</th>
      <th>L2 正则化</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>范数定义</td>
      <td>$|w|_1 = \sum |w_i|$</td>
      <td>$|w|_2^2 = \sum w_i^2$</td>
    </tr>
    <tr>
      <td>对应约束</td>
      <td>$|w|_1 \leq C$</td>
      <td>$|w|_2^2 \leq C$</td>
    </tr>
    <tr>
      <td>几何形状</td>
      <td>L1 球（菱形/多面体）</td>
      <td>L2 球（圆形/椭球）</td>
    </tr>
    <tr>
      <td>解的结构</td>
      <td>稀疏，偏好角点（$w_i = 0$）</td>
      <td>平滑收缩，解非稀疏</td>
    </tr>
    <tr>
      <td>应用场景</td>
      <td>特征选择、模型压缩</td>
      <td>防止过拟合、提升稳定性</td>
    </tr>
  </tbody>
</table>

<p>因此，从约束角度理解 L1 与 L2 正则化，不仅揭示了其在几何与优化性质上的根本差异，也为正则项选择提供了理论依据和实践指导。</p>]]></content><author><name>Jiarui Han</name><email>tjbillhan@gmail.com</email></author><category term="Machine Learning" /><category term="Regularization" /><summary type="html"><![CDATA[最近被同学问到了机器学习里正则化这一概念的一些问题，包括如何理解 L1 和 L2 正则化起到的效果。在讨论的过程中，我们从约束的角度尝试理解了为什么 L1 正则化可能使参数为 0，而 L2 正则化更倾向于缩小参数。]]></summary></entry><entry><title type="html">RSCMR技术最新文献调研（2025年6月更新）</title><link href="https://billhan01.github.io/posts/2025/06/RSCMR%E6%8A%80%E6%9C%AF%E6%9C%80%E6%96%B0%E6%96%87%E7%8C%AE%E8%B0%83%E7%A0%94/" rel="alternate" type="text/html" title="RSCMR技术最新文献调研（2025年6月更新）" /><published>2025-06-22T00:00:00+08:00</published><updated>2025-06-22T00:00:00+08:00</updated><id>https://billhan01.github.io/posts/2025/06/2025%E5%B9%B46%E6%9C%88%E9%81%A5%E6%84%9F%E5%9B%BE%E5%83%8F%E8%B7%A8%E6%A8%A1%E6%80%81%E6%A3%80%E7%B4%A2%E6%8A%80%E6%9C%AF%E8%B0%83%E7%A0%94</id><content type="html" xml:base="https://billhan01.github.io/posts/2025/06/RSCMR%E6%8A%80%E6%9C%AF%E6%9C%80%E6%96%B0%E6%96%87%E7%8C%AE%E8%B0%83%E7%A0%94/"><![CDATA[<p>本文回顾总结了近期在遥感图像跨模态检索领域的一些最新文献资源。</p>

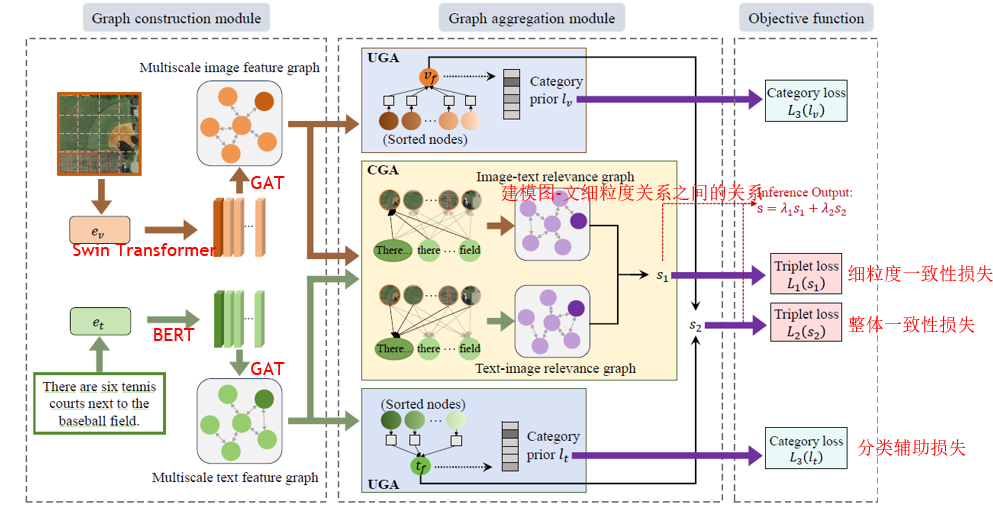
<h1 id="graph-based-hierarchical-semantic-consistency-network-for-remote-sensing-image-text-retrieval">Graph-based hierarchical semantic consistency network for remote sensing image-text retrieval</h1>

<blockquote>
  <p><strong>Authors</strong>: Meiting Wang, Jie Guo*, Senior Member, IEEE, Bin Song, Senior Member, IEEE, Kangxiang Su</p>

  <p><strong>Journal</strong>: IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing (Early Access)</p>

  <p><strong>Date of Publication:</strong> 11 June 2025</p>

  <p><strong>Link</strong>: https://ieeexplore.ieee.org/abstract/document/11031116</p>

  <p><strong>Keywords</strong>: remote sensing image-text retrieval (RSITR), cross-modal similarity, graph neural networks, feature aggregation,
hierarchical alignment</p>

  <p><strong>Type</strong>: Swin Transformer/BERT+GNN</p>
</blockquote>

<h2 id="the-problem">The Problem</h2>

<ul>
  <li>
    <p><strong>问题一：缺乏模态间语义交互，跨模态对齐不精准</strong></p>

    <ul>
      <li>
        <p>现有方法通常将图像与文本分别提取特征，然后在共享空间进行对齐。</p>
      </li>
      <li>
        <p>这种“整体特征对齐”方式忽视了模态间细粒度的语义交互，难以有效区分语义相近但细节不同的数据。</p>
      </li>
      <li>
        <p>模型可能忽略图像中语义不一致的片段，导致检索错误。</p>
      </li>
    </ul>
  </li>
  <li>
    <p><strong>问题二：局部特征聚合方式简单，导致信息损失</strong></p>
    <ul>
      <li>多数方法采用简单的门控机制（如 sigmoid + 乘法）对图像区域或文本词汇进行聚合，无法有效整合不显眼对象或抽象语义。</li>
      <li>在视觉上高度相似的图像之间，仅依赖显著目标（如“船”、“港口”）的语义很难区分；对象之间的空间关系、相对位置等结构化语义信息被忽视。</li>
    </ul>
  </li>
</ul>

<h2 id="motivation">Motivation</h2>

<ul>
  <li><strong>动机一：充分利用图神经网络（GNN）建模复杂语义关系</strong>
    <ul>
      <li>GNN 能够有效建模图像区域或文本单元之间的局部关系和结构依赖。在自然图文检索中，GNN 已展示出在建模语义交互方面的潜力。</li>
      <li>遥感图像中的目标具有尺度多样、布局复杂等特点，非常适合使用 GNN 来捕捉细粒度结构化语义。</li>
    </ul>
  </li>
  <li><strong>动机二：实现层次语义一致性，从整体到细节优化检索效果</strong>
    <ul>
      <li>相比传统方法仅对整体特征进行匹配，引入“层次语义一致性”概念，即同时对齐整体语义和局部语义（如重要对象）</li>
    </ul>
  </li>
  <li><strong>动机三：构建更加精细的图结构融合策略</strong>
    <ul>
      <li>一方面在单模态内部自适应融合显著性特征；另一方面进行模态间交互，捕捉图像与文本间的细粒度语义对应关系，以此增强特征判别性、改善语义匹配效果，实现更精准的图文检索。</li>
    </ul>
  </li>
</ul>

<h2 id="the-approach">The Approach</h2>

<p><img src="/images/image-250622-01.png" alt="image-250622-01" style="zoom:80%;" /></p>

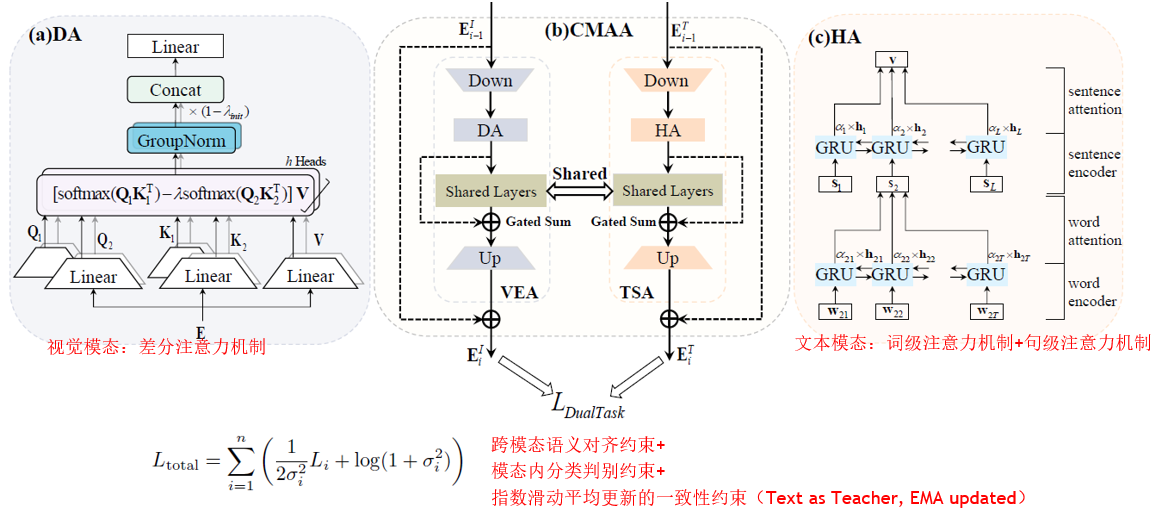
<h1 id="representation-discrepancy-bridging-method-for-remote-sensing-image-text-retrieval">Representation Discrepancy Bridging Method for Remote Sensing Image-Text Retrieval</h1>

<blockquote>
  <p><strong>Authors</strong>: Hailong Ning, Siying Wang, Tao Lei, Xiaopeng Cao, Huanmin Dou, Bin Zhao, Asoke K. Nandi, Petia Radeva</p>

  <p><strong>Journal</strong>: arXiv</p>

  <p><strong>Date of Publication:</strong> 23 May 2025</p>

  <p><strong>Link</strong>: https://arxiv.org/abs/2505.16756</p>

  <p><strong>Keywords</strong>: Remote Sensing Image-Text Retrieval, Vision-and-Language Pre-training, Parameter-Efficient Fine-Tuning, Cross-Modal Asymmetric Adapter, Multi-Task Learning</p>

  <p><strong>Type</strong>: GeoRSCLIP(ViT-B-32-RET-2) + Adapter PEFT</p>
</blockquote>

<h2 id="the-problem-1">The Problem</h2>

<ul>
  <li><strong>问题一：模态优化不对称：文本主导图像</strong>
    <ul>
      <li>文本模态语义判别性强、表达集中，在训练中容易主导优化；图像模态则冗余多、语义分散，特征提取难度更高。</li>
      <li>现有主流 PEFT（参数高效微调）方法普遍采用对称适配器结构（图像与文本使用相同结构），未考虑两者特性差异。</li>
    </ul>
  </li>
  <li><strong>问题二：单任务训练约束弱，缺乏鲁棒对齐能力</strong>
    <ul>
      <li>多数现有 RSITR 模型采用单一的图文匹配任务进行训练，缺乏对模态内判别性、训练过程分布稳定性的辅助约束，对遥感图像中多目标、大尺度、跨域分布变化强的特点适应性差。</li>
    </ul>
  </li>
</ul>

<h2 id="motivation-1">Motivation</h2>

<ul>
  <li><strong>动机一：打破对称结构限制</strong>
    <ul>
      <li>引入非对称适配器结构（CMAA），让图像和文本分别使用更适配自身结构的调优策略。</li>
      <li>图像使用差分注意力（DA）提取细粒度视觉特征；文本使用层次注意力（HA）增强语义提取。</li>
    </ul>
  </li>
  <li><strong>动机二：提升微调过程的泛化与稳定性</strong>
    <ul>
      <li>单一任务的微调方法约束不够；引入双任务一致性损失（DTCL），强化跨模态对齐，引入模态内分类监督；增加指数滑动一致性项，提升训练稳定性。</li>
    </ul>
  </li>
</ul>

<h2 id="the-approach-1">The Approach</h2>

<p><img src="/images/image-250622-02.png" alt="image-250622-02" style="zoom:80%;" /></p>

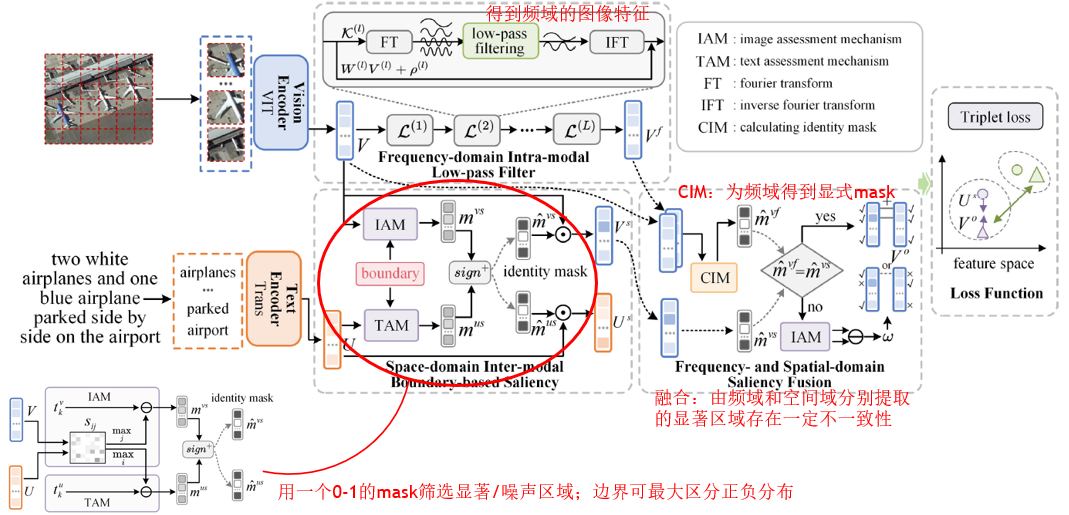
<h1 id="frequency--and-spatial-domain-saliency-network-for-remote-sensing-cross-modal-retrieval">Frequency- and Spatial-Domain Saliency Network for Remote Sensing Cross-Modal Retrieval</h1>

<blockquote>
  <p><strong>Authors</strong>: Chengyu Zheng , Jie Nie , Member, IEEE, Bo Yin , Member, IEEE, Xiu Li , Yuntao Qian , Senior Member, IEEE, and Zhiqiang Wei , Member, IEEE</p>

  <p><strong>Journal</strong>: IEEE Transactions on Geoscience and Remote Sensing (Volume: 63)</p>

  <p><strong>Date of Publication:</strong> 16 April 2025</p>

  <p><strong>Link</strong>: https://ieeexplore.ieee.org/abstract/document/10966929</p>

  <p><strong>Keywords</strong>: Cross-modal retrieval, remote sensing (RS), spatial and frequency</p>

  <p><strong>Type</strong>: RemoteCLIP+Fourier Transform</p>
</blockquote>

<h2 id="the-problem-2">The Problem</h2>

<ul>
  <li>本文旨在解决遥感图文跨模态检索中的特征表示不鲁棒、噪声干扰大、模态对齐困难等关键问题，具体表现为空间域显著性建模方法的局限。
    <ul>
      <li>现有方法主要基于空间域（如卷积、注意力机制）提取特征，但遥感图像因低分辨率、高噪声、目标分散，容易在训练过程中引入噪声转移、信息平滑、小目标丢失等问题。这种处理方式无法有效过滤遥感图像中由传感器距离、大气干扰等引起的噪声，降低了跨模态检索的准确性。</li>
    </ul>
  </li>
</ul>

<h2 id="motivation-2">Motivation</h2>

<ul>
  <li>动机一：引入频域建模，利用低频去噪能力增强特征鲁棒性
    <ul>
      <li>使用傅里叶变换 + 低通滤波，提取低频主干结构（如道路、建筑）；剔除高频中的纹理扰动与大气噪声，从而获取更稳定的图像表示；</li>
      <li>是首个在 RSITR 中系统引入频域显著性学习的研究。</li>
    </ul>
  </li>
  <li>动机二：抛弃传统跨模态注意力机制，引入边界引导的空间显著性挖掘
    <ul>
      <li>基于图文相似度分布差异，引入相似度边界而非注意力迁移；不再依赖“信息从另一模态引导”的思路，显著减少跨模态噪声扩散。</li>
    </ul>
  </li>
  <li>动机三：融合空间与频域特征，引入双掩码一致性机制提升融合可信度
    <ul>
      <li>提供了一种可信度驱动的多域显著性融合机制，实现多源特征自适应互补。</li>
    </ul>
  </li>
</ul>

<h2 id="the-approach-2">The Approach</h2>

<p><img src="/images/image-250622-03.png" alt="image-250622-03" style="zoom:80%;" /></p>]]></content><author><name>Jiarui Han</name><email>tjbillhan@gmail.com</email></author><category term="RSCMR" /><category term="Literature Share" /><summary type="html"><![CDATA[本文回顾总结了近期在遥感图像跨模态检索领域的一些最新文献资源。]]></summary></entry><entry><title type="html">关于人工智能前沿的十个问题</title><link href="https://billhan01.github.io/posts/2025/06/%E5%85%B3%E4%BA%8E%E4%BA%BA%E5%B7%A5%E6%99%BA%E8%83%BD%E5%89%8D%E6%B2%BF%E7%9A%84%E5%8D%81%E4%B8%AA%E9%97%AE%E9%A2%98/" rel="alternate" type="text/html" title="关于人工智能前沿的十个问题" /><published>2025-06-19T00:00:00+08:00</published><updated>2025-06-19T00:00:00+08:00</updated><id>https://billhan01.github.io/posts/2025/06/%5B%E8%BD%AC%5D%E5%85%B3%E4%BA%8E%E4%BA%BA%E5%B7%A5%E6%99%BA%E8%83%BD%E5%89%8D%E6%B2%BF%E7%9A%84%E5%8D%81%E4%B8%AA%E9%97%AE%E9%A2%98</id><content type="html" xml:base="https://billhan01.github.io/posts/2025/06/%E5%85%B3%E4%BA%8E%E4%BA%BA%E5%B7%A5%E6%99%BA%E8%83%BD%E5%89%8D%E6%B2%BF%E7%9A%84%E5%8D%81%E4%B8%AA%E9%97%AE%E9%A2%98/"><![CDATA[<blockquote>
  <p>本文转自上海人工智能实验室（Shanghai AI Lab），系上海人工智能实验室主任、首席科学家，清华大学惠妍讲席教授周伯文于2025年6月13日在星河学术社区首届明珠湖会议所作的开场报告。</p>
</blockquote>

<h1 id="关于人工智能前沿的十个问题">关于人工智能前沿的十个问题</h1>

<h2 id="科学社区的力量创新的摇篮">科学社区的力量：创新的摇篮</h2>

<p>欢迎各位专家与青年朋友参加明珠湖会议。</p>

<p>我们今天正式启动了一个全新的科学社区——星河社区。首先我想分享几个故事，跟大家探讨一下，为什么需要科学社区的力量。</p>

<p>众所周知，现代科学起源于英国，英国现代科学的一个典型标志是英国皇家学会，它成立于1660年，是世界上历史最悠久、从未中断的科学学会。但其实它有着更久远的渊源——一群科学家在1618年发起了非正式运行的“隐形学院”（Invisible College）——这种紧密的交流塑造了近代科学精神。例如，英国皇家学会成员中，牛顿奠定了经典力学基础，霍金则在黑洞理论和宇宙学中揭示了时空的奥秘。</p>

<p>科学研究离不开思想碰撞。另一方面，现在追求创新链和产业链的融合，在产业链，也一样需要碰撞和交流。</p>

<p>1765年，工业革命的发源地英国伯明翰诞生了一个社区——这也印证了科学先行、技术跟随的理念。这一社区最早的发起人有瓦特等在工业革命史留下名字的人，他们以组织晚餐俱乐部的形式定期聚会。聚会时间往往选择在满月之夜，因为在没有路灯的情况下，月光可以帮他们照亮回家的路——这个团体因而取名为“月光社”（Lunar Society）。“月光”社孕育了许多著名人物，如“热力学之父”开尔文勋爵；也催生了许多突破性的发明发现，如博尔顿与瓦特公司（Boulton &amp; Watt）对蒸汽机的改造推动了第一次工业革命。</p>

<p>时钟拨转到20世纪，在计算机领域，美国高级研究计划局（Advanced Research Project Agency）在1960年代资助了众多美国计算机科学领域的研究。其中一项划时代的工作是阿帕网（ARPANET）——全球互联网的鼻祖。</p>

<p>阿帕网还带来了一个“副产品”。</p>

<p>最初的“阿帕网”，由西海岸的4个节点构成，包括加州大学洛杉矶分校（UCLA）、斯坦福研究院（SRI）、加州大学圣巴巴拉分校（UCSB）和犹他大学（UTAH）。后来阿帕网陆续扩展到其他大学。</p>

<p>在计算机历史的重要著作《The Dream Machine》（梦想机器）中，记录了个人计算机和互联网诞生背后关键的一群人，其中的一个故事是：阿帕网各个节点所在的高校，每年会派出各自实验室最优秀的青年聚在一起，既参加封闭研讨，也并肩滑雪、交流谈心——就好像今天的明珠湖会议一样。这群人自称为“阿帕社区”（ARPA Community），从美国西海岸到东海岸，横跨美国大陆的这批青年学者在此过程中建立起了紧密的友谊和共同的目标。</p>

<p>这个社区最了不起的成果之一，就是成就了一批优秀的成员。尽管随着时间的流逝，阿帕网逐渐淡出了历史舞台，但“阿帕社区”的成员继续协作。其中有的人从学术界进入到产业界，参与创造出了个人计算机、GUI、面向对象编程、激光打印机、点对点网络、PostScript界面等划时代的成果。这个社区有7位成员先后获得了图灵奖。</p>

<h2 id="对发现问题的投入与解决问题同样重要">对发现问题的投入，与解决问题同样重要</h2>

<p>基于上述出发点，我认为我们首先要做的是提出问题、发现问题。</p>

<p>在科学研究领域，对发现问题的投入与解决问题同样重要——这一点在科学界早有共识，但没有得到足够重视。</p>

<p>“阿帕社区”成员之一，艾伦·凯（Alan Kay，面向对象编程与GUI先驱，2003图灵奖获得者）曾说：相比解决问题的过程，对发现问题的过程进行资助往往更重要，但这一过程往被忽视。“辛烷值”提出者、雷达系统设计者之一亨利·蒂泽德（Henry Tizard）认为，“科学的秘密在于提出正确的问题，而<strong>对问题的选择是否得当</strong>是科学天才的重要标志。”</p>

<p>另一个例子是计算机科学、数学家理查德·汉明（Richard Hamming）。由于他喜欢追着别人问“你们领域最关键的问题是什么”，因而在社交场合一度不太受欢迎。他这么问一方面是为了用“那你们为什么不研究这些问题呢？”来调侃对方，另一方面则是因为这个问题确实能有效引导人们聚焦于真正重要的问题。这两个问题被称为“<strong>汉明问题</strong>”（Hamming Questions）。</p>

<p>历史证明，能回答这两个问题的人都在各自领域大有成就，而那些不能回答的人则默默无闻。所以说，这就是提出好问题的力量。</p>

<p>今天，我们召开明珠湖会议，正是基于对社区力量、提出问题的重视。希望通过这个平台，聚集志同道合挑战科学边界的研究者，让大家充分思考、讨论，甚至激辩，从而发现问题，提出问题，并尝试找到答案。</p>

<p>在会议的组织上，我们也尝试了一系列创新。首先，通过引导报告提出问题；其次，通过“结对报告”（Pair Talk，让观点不同的人做同一个报告）凝练问题；最后，在平行论坛环节深化问题。明珠湖会议的目标聚焦于提出问题，让参与者抛开资金和资源限制，思考自己真正愿意研究的问题。</p>

<p>与其他学术会议不同的是，我们希望明珠湖会议能做到以终为始、战略引领。因此，我们讨论的问题都有明确的时间边界，聚焦18-36个月的技术窗口期——通过这种设定，让大家专注于真正重要的问题。</p>

<p>在问题导向的过程中，我们希望参与者专注于“干什么”，而无需受到学历、资历和组织架构等因素的限制。</p>

<p>我们还希望结合国家在人工智能创新领域的支持，帮助大家快速落地研究成果。明珠湖会议的预期产出是具有颠覆性的关键问题清单，并初步形成敏捷部署提案。在成果落地方面，我们有丰富的载体，如上海人工智能实验室的开放课题、“AI4S攀登者行动计划”等项目，以及上海市和国家相关重大研究项目等，可以从不同的层次、资金规模和边界条件出发，为提出的问题找到适配的规划路径。最终沉淀下来的关键问题还将面向社区开放，邀请更多有能力的同行者进行“答题”。</p>

<h2 id="ai前沿十问未来关键技术节点"><strong>AI前沿十问：未来关键技术节点</strong></h2>

<p>本次会议的主题是“人工智能的多维突破与协同创新”，关于人工智能未来3-5年发展趋势，我尝试总结为“三化”。</p>

<p>第一个是<strong>智能技术体系化</strong>。人工智能是一个非常典型的先发展应用，后补充理论的一个学科，发展到现在这个阶段，需要更体系化地去追究智能的本质，更好地去完善这个体系。</p>

<p>第二个是<strong>智能形态多元化</strong>。习近平总书记多次强调要“加强人工智能和产业发展融合”“突出应用导向”“加速各领域科技创新突破”。</p>

<p>所以人工智能一定要产生不同的形态，和实体经济、社会发展、人民生活紧密结合，随着人工智能技术的迭代，它一定会出现智能形态多元化。形态多元化的核心原因，一个是场景丰富度的要求，另一个是因为技术不完备，人工智能未来四五年中还会处于一个技术待完备的过程，这时候就需要妥协，在应用中考虑新的形态。所以这里就带来一个新问题，要思考人工智能产业的形态呈现出来的是过程还是终局，是手段还是目的？在这一点上，我们要充分听取来自学术界、产业界和投资界的声音。</p>

<p>第三个是<strong>智能能力高阶化</strong>。行业往前发展的核心动力是智能能力必须不断进行高阶化演进。今天的人工智能已经让大家惊叹，但我相信这仅仅是开始。高阶化离不开技术体系化，离不开要素的突破，离不开对形态的理解。否则，基于中阶过程去探讨人工智能的高阶化，就有可能走上错误的道路。</p>

<p>以上是我针对“人工智能未来发展趋势”的框架性思考，而针对人工智能未来关键技术节点的判断，我总结提出了十个问题，这些问题至今还没有确定的答案。今天借此机会与大家分享，希望可以和大家一起探讨。</p>

<h3 id="1总体智能-vs-单位智能如何平衡智能发展的质量与效率"><strong>1、总体智能</strong> <strong>vs</strong> 单位智能：如何平衡智能发展的质量与效率？</h3>

<p>我们从去年开始思考：当前评估模型时，往往关注总体智能——参数规模、训练数据量和排行榜排名。而忽略了另外一个也很重要的指标——<strong>单位智能</strong>（IQ per token）。这一指标涵盖数据成本、计算成本和存储成本，类似于经济学中的人均GDP概念。</p>

<p>在模型评估中，若能实现单位智能最大化，那么总体智能将会显著提升。DeepSeek模型的工程创新使模型更为简洁，这种简洁本身就是智能的高级表现。2025年1月，上海人工智能实验室正式提出数据思维密度（IQPT，Intelligence Quality per Token），定义为模型平均性能与训练数据量的比值，可以衡量大模型训练数据的“投入产出比”。今年3月，OpenAI研究负责人诺姆·布朗（Noam Brown）也分享了单位成本智能的相关观点。</p>

<h3 id="2deep-rl规模化发展的资源悖论如何平衡数据合成和算法训练两大任务的算力分配"><strong>2、Deep RL规模化发展的资源悖论：如何平衡“数据合成”和“算法训练”两大任务的算力分配？</strong></h3>

<p>深度强化学习（Deep RL）不仅是学习手段，同时也是一条能够产出高价值数据的高效路径。在运行过程中，它一方面会消耗一定的算力资源，另一方面却能生成具备高精度、高密度特性的复杂推理数据。值得关注的是，这些合成数据可以反哺预训练环节，从而显著提升模型性能。</p>

<p>因此，在理想状态下，我们可以追求<strong>效率飞轮</strong>：通过Deep RL消耗的算力与其产生的高质量数据所节省的训练成本达成平衡。当这个临界点到来，AI或将能以极低成本自我提升，实现“自己训练自己”。</p>

<h3 id="3软硬协同创新软件向硬件适配还是硬件向软件兼容">3、软硬协同创新：软件向硬件适配，还是硬件向软件兼容？</h3>

<p>软硬协同的路径国内外存在差异，国际厂商如英伟达选择 “软件兼容硬件”，通过深耕CUDA生态，使其软件能够高度适配自家硬件；而国内目前更多是“硬件兼容软件”，例如芯片厂商调整算子以适配软件需求。</p>

<p>然而，硬件研发的周期通常要比软件长得多，这就导致“硬件兼容软件”这条路径在逻辑上遭遇了挑战。学术界应探索更高效的软硬协同创新路径，既要实现软硬件在性能上的优化，也要紧密贴合产业实际需求，为产业发展提供更有力的支持，促进整个产业链的良性循环与升级。</p>

<h3 id="4算力受限的影响针对应用迭代和颠覆性的技术算力应如何配置">4、算力受限的影响：针对应用、迭代和颠覆性的技术，算力应如何配置？</h3>

<p>从算力运用的维度来看，可将其划分为三类：</p>

<p>一是应用算力（For Application），聚焦于已明确的场景应用，通过加大算力投入，全力推动科研成果实现产业落地，将理论转化为实际生产力，促进产业的发展与升级。</p>

<p>二是迭代算力（For Incremental），此类算力助力研究工作持续推进与模型迭代优化，例如依据 Scaling Law 投入算力开展模型训练等相关工作。</p>

<p>三是创新算力（For Disruptive），其核心作用在于对非主流想法进行验证，积极探索更多尚未被充分发掘的新技术，拓展多样化的新解决方案。</p>

<p>当前，应用算力和迭代算力相对充足，而创新算力严重不足，这对于颠覆性想法的产生与发展形成了潜在挑战。要想避免研究走向同质化困境，实现创新算力供给至关重要。这种供给应当鼓励差异化思考，并为非主流技术路线提供支持。</p>

<h3 id="5agent与基础模型的关系agent是目的还是过程如何构建真正自主进化的智能体">5、Agent与基础模型的关系：Agent是目的还是过程？如何构建真正自主进化的智能体？</h3>

<p>早在2023年，我们便提出下一代大模型操作系统应该是融合语言能力的工具平台，其实与现在的Agent不谋而合。Agent和基座模型是什么样的关系？Agent是目的还是手段？这值得我们思考。</p>

<p>从Agent发展情况看，它是依赖于基础模型的，同时还需要通过与环境和用户的互动不断学习和自我改进。当前大多数自我改进系统都陷入了“僵化学习”的困境 。DeepMind科学家乔纳森·里奇恩斯（Jonathan Richens）今年6月发布论文，表明实现具有通用智能的智能体（AGI），必然学习到了环境的预测模型（世界模型）。无论是在动态环境中，还是在任务复杂度日益上升的背景下，世界模型都是不可或缺的基础。</p>

<p>人类智能的一个核心特征便是其永无止境的学习能力——不断吸收新知识、适应环境变化，并对过往经验进行深刻的总结、迁移与升华。智能体系统是否也有可能具备类似的、真正意义上的持续学习能力，甚至在此基础上实现某种形式的“自主进化”？</p>

<h3 id="6具身智能超级大脑与本体的关系-如何突破莫拉维克悖论实现类人的具身进化和环境自适应">6、具身智能：超级大脑与本体的关系? 如何突破“莫拉维克悖论”？实现类人的具身进化和环境自适应？</h3>

<p>在具身智能的研究范畴里，如何精准定义 “大脑” 与 “本体” 之间的关系，已成为核心且亟待攻克的关键问题。人类作为“智能体”，在本体能力维度，诸如力量、速度等方面，人类相较于众多动物存在明显劣势。然而，人类却凭借独特的工具创造能力、环境交互与学习的能力，成功突破了自身生理局限，达成诸多超越想象的成就。</p>

<p>因此，未来的具身智能研究应当深入探究大脑与本体间的最优关系，并据此制定资源投入的最佳策略。既避免“超级大脑-弱本体”的陷阱，也避免“高级本体-简单决策”的陷阱。从而推动具身智能技术取得实质性、突破性进展。</p>

<h3 id="7安全可信-vs-智能如何从make-ai-safe-到-make-safe-ai">7、安全可信 vs 智能：如何从Make AI Safe 到 Make Safe AI？</h3>

<p>人工智能正以前所未有的速度发展，当前面临的核心挑战是：如何从被动的“弥补AI安全漏洞”（Make AI Safe）转向主动的“构建本质安全的AI”（Make Safe AI）?</p>

<p>2024年，我们提出“人工智能45°平衡律”：安全不应是AI系统的后期附加功能，而必须作为核心设计原则贯穿始终。2025年，约书亚·本吉奥（Yoshua Bengio）倡导的“设计即安全”（Safety by Design）也反映出这一点。</p>

<p>近期，形式化AI取得较多进展，华裔数学家陶哲轩的“Lean+AI=数学证明智能化”概念，以及创业公司Ndea的程序合成（program synthesis）技术，都体现了通过数学严谨性确保系统行为可验证。形式化AI有巨大潜力，但同时也存在一定的问题：会否由于限制太强，使系统灵活度下降，从而出现为了完成任务而“绕过安全检查”，最终导致病变？自动形式化、形式化验证是确保AI 100% 安全的路径吗？还有哪些可行的技术方案，比如Causal AI（因果人工智能）、Explainable AI（可解释人工智能）等？真正的AI安全需要的不是完美的规范，而是具备自我修正能力的动态安全机制。</p>

<h3 id="8高分-vs-高能从静态到动态-训练评测解决问题一体化面向agi的评测应如何建设">8、高分 vs 高能：从静态到动态? 训练、评测、解决问题一体化？面向AGI的评测应如何建设？</h3>

<p>“AI上半场”聚焦于开发新的训练方法和模型架构，但模型任务与真实世界的“效用”存在脱节，暴露出当下评测体系“高分低能”的问题。因此“AI下半场”将聚焦于“现实世界的任务定义与评估体系重构”。</p>

<p>新评测体系要从能力导向（构建评测问题）到任务导向 （独立/辅助人类解决现实世界中的高价值问题）迁移，评测和解决问题可能会变成一体化，即在训练中评测、在评测中训练，在“干中学”在“学中干”。</p>

<p>2025年4月，我们发布了“测试时强化学习”（Test-Time Reinforcement Learning, TTRL）框架研究论文，探索在没有准确标签的情况下进行奖励估计，驱动模型朝着正确的方向学习。同期，Google DeepMind 强化学习团队副总裁David Silver与图灵奖得主、强化学习之父Richard Sutton共同发表文章《Welcome to the Era of Experience》，与TTRL框架理念相似。</p>

<h3 id="9下一代ai-for-science如何从工具的革命到革命的工具">9、下一代AI for Science：如何从“工具的革命”到“革命的工具”？</h3>

<p>AI for Science要真正发挥革命性作用，必须理解科学研究的本质：研究者、研究工具、研究对象三者的交互关系。目前的AI for Science主要关注研究工具层面的单点效率提升（“工具的革命”），而我们需要追求的是能够带来科学范式转变的“革命性工具”，并实现科研各环节全链条水平提升。下一代For Science的AI，如何从“工具的革命”变成“革命的工具”应该是我们这一代人的使命。</p>

<p>如果要成为“革命的工具”，现在的语言模型是否够用？若没有多模态的智能涌现，或许很难实现革命性的AI for Science工具。当前的多模态模型仍然建立在预测下一个token的基础上，缺乏对图表、分子模型、公式和实验观察的深度理解能力。打造能够推动科学突破的AI系统，需要在多模态统一表征方面取得突破。</p>

<h3 id="10颠覆性架构是什么针对transformer的不足什么架构能够带来根本性创新">10、颠覆性架构是什么？针对Transformer的不足，什么架构能够带来根本性创新？</h3>

<p>Transformer架构自2017年问世以来，引领了AI领域的一场革命。从GPT系列到Claude，从DALL-E到Gemini，几乎所有令人印象深刻的大型语言模型和多模态模型都建立在这一架构之上。然而，随着我们对AI能力的期望不断提高，Transformer的一些内在局限性逐渐显现，包括计算效率不高、上下文理解有限、推理能力存在瓶颈、难以模拟动态系统等。正如爱因斯坦所言：“我们不能用制造问题时的思维方式来解决问题”。突破这些局限，可能需要全新的架构思路。展望未来，除了Transformer自身架构的持续迭代，未来多元架构如何共存、互补和协作？针对决策智能、世界智能、生物智能等领域需要探索可能引领下一代的AI架构。</p>

<h2 id="如何实现战略科学家群体涌现"><strong>如何实现战略科学家“群体涌现”</strong></h2>

<p>上面讨论了科学社区及提出好问题的重要性，如果我们把目光投向更聚焦的人群——战略科学家，就会发现，在许多关键的历史时期，都出现了战略科学家“群体涌现”的效应。</p>

<p>例如，1920年代，世界上涌现出了一批史称匈牙利“黄金一代”的战略科学家，包括计算机之父冯·诺依曼、氢弹之父爱德华·特勒，以及钱学森的导师——超音速飞行之父冯·卡门等。1970至80年代PC革命，美国涌现出比尔·盖茨、乔布斯等，他们均出生于1955年。如今人工智能领域也出现了顶尖科技人才集聚效应，OpenAI发布世界首个深度思考与推理大模型o1，其核心技术的七位负责人中，五位来自波兰。</p>

<p>但是，战略科学家人选难以在早期预判。二战后，美国基础研究奠基人范内瓦·布什（Vannevar Bush）曾在给美国总统杜鲁门的信中写道：“战略科学家的形成是一个长期且复杂的过程，涉及个人智力、意愿、身体健康、精力、目标导向等多个方面”。</p>

<p>历史证明，战略科学家往往在承担重大任务时，在有研判、有管理、有组织能力的群体中产生。承担重大科研攻关项目是成为战略科学家不可或缺的条件。以我国的“两弹一星”工程为例，大量科学家通过参与这一国家重大科技工程，不仅发挥出其卓越的科研能力，也展现了非凡的战略眼光和领导力。</p>

<p>我们一直把科学社区问题驱动作为培养战略科学家的输入点，并为战略科学家成长创造条件。当前通用人工智能处于爆发前夜，存在非常难得的窗口期，亟待通过重大组织模式创新，发现、选拔，并培育出一批战略科学家。</p>

<p>实验室广泛链接国内外优秀科研团队和人才，并探索通过构建科学社区，形成战略科技人才蓄水池，以问题为驱动，形成“<strong>高强度要素投入+高集中任务攻关+高密度人才历练场</strong>”三位一体的培育模式，让真正有潜力的青年科学家在潜心研究的过程中，持续提升前瞻性判断、跨学科理解能力、组织领导等核心能力，最终成长为战略科学家。</p>]]></content><author><name>Jiarui Han</name><email>tjbillhan@gmail.com</email></author><category term="Future of AI" /><category term="Foundational AI Questions" /><category term="AI Trends 2025" /><summary type="html"><![CDATA[本文转自上海人工智能实验室（Shanghai AI Lab），系上海人工智能实验室主任、首席科学家，清华大学惠妍讲席教授周伯文于2025年6月13日在星河学术社区首届明珠湖会议所作的开场报告。]]></summary></entry><entry><title type="html">My first Post</title><link href="https://billhan01.github.io/posts/2025/06/my-first-post/" rel="alternate" type="text/html" title="My first Post" /><published>2025-06-09T00:00:00+08:00</published><updated>2025-06-09T00:00:00+08:00</updated><id>https://billhan01.github.io/posts/2025/06/my-first-post</id><content type="html" xml:base="https://billhan01.github.io/posts/2025/06/my-first-post/"><![CDATA[<p>I’m Jiarui Han, currently pursuing my Master’s degree in Computer Science at Tongji University. I work with Prof. Jihong Guan and Assoc. Prof. Wengen Li at the ADMIS Lab, focusing on cross-modal learning and remote sensing applications.</p>

<p>I plan to use this space to share things I’m working on, interesting papers I come across, and maybe a few thoughts on life as a graduate student.</p>

<p>Thanks for stopping by — more to come soon!</p>]]></content><author><name>Jiarui Han</name><email>tjbillhan@gmail.com</email></author><category term="FirstPost" /><category term="GradLife" /><category term="HelloWorld" /><summary type="html"><![CDATA[I’m Jiarui Han, currently pursuing my Master’s degree in Computer Science at Tongji University. I work with Prof. Jihong Guan and Assoc. Prof. Wengen Li at the ADMIS Lab, focusing on cross-modal learning and remote sensing applications.]]></summary></entry></feed>